O custo oculto do QA não testado em serviços financeiros
O QA manual custa milhões por ano aos contact centers. Mas o risco maior está nos scorecards que nunca foram validados contra resultados reais de clientes.
O novo cenário do QA
Os call centers resolvem o problema do cliente na primeira ligação em cerca de 71% das vezes, segundo o benchmark do setor da SQM Group. Ou seja: quase três em cada 10 clientes precisam ligar de novo pelo mesmo motivo. E a lacuna cresce a partir daí. Quando a ligação não resolve na primeira tentativa, a satisfação do cliente cai cerca de 15% a cada nova ligação que ele precisa fazer, e 80% desses clientes dizem estar insatisfeitos com a forma como o agente conduziu o atendimento.
As instituições financeiras também estão acelerando em IA. A pesquisa bancária de 2026 da Cornerstone Advisors, feita com executivos seniores de bancos e cooperativas de crédito, mostrou que 59% das cooperativas e 49% dos bancos já colocaram IA generativa em produção. Considerando todos os setores, a pesquisa de 2026 da Deloitte Digital com líderes de contact center mostrou que 35% já usam IA agêntica na operação.
Boa parte dessa IA vai direto para a linha de frente, em cima de um processo de QA que ninguém revisita há anos. Nessa escala, o que está em jogo muda. Uma pessoa num dia ruim afeta algumas ligações. Um agente de IA repetindo o mesmo erro pode afetar as próximas mil, na hora, antes que alguém perceba. E em muitos programas ninguém independente cobra dos bots o mesmo padrão cobrado das pessoas: eles são avaliados por outra ferramenta, ou até pelo próprio fornecedor que os vende.
Quase todo contact center tem um programa de quality assurance feito para pegar problemas antes que eles se acumulem: um scorecard, um processo de amostragem, uma rotina de calibração. Segundo uma estimativa do setor, 92% têm um programa formal de QA, mas, na maioria deles, a revisão manual cobre só de 2% a 5% das conversas.
Só que existe um problema mais estrutural do que a amostragem manual. A maioria dos scorecards usados para medir qualidade nunca foi testada para ver se prevê resultados reais de clientes. O resultado é um processo de qualidade que parece rigoroso no papel, passa confiança internamente e, na prática, pode estar medindo quase nada do que importa para o negócio.
Este relatório estima o custo do QA manual e de baixa cobertura, que chega a milhões de dólares por ano, e detalha um risco potencialmente maior: um scorecard que ninguém nunca comparou com resultados reais. Esse segundo risco é mais difícil de quantificar, e não desaparece quando o QA é automatizado.

A maioria dos scorecards usados para medir qualidade nunca foi testada para ver se prevê resultados reais de clientes.
Calibrado não significa correto
A cobertura é o problema mais visível. Revisar só uma fatia das conversas já basta para esconder problemas reais, e caros, dentro dos 95% que ninguém nunca olha.
Mas resolver a cobertura não resolve o problema estrutural. Busque "como montar um scorecard de QA para call center" e aparecem dezenas de guias, de fornecedores, associações e consultorias. Em geral, eles concordam: divida o scorecard em algumas seções, dê pesos aos critérios, use uma escala de cinco pontos e calibre até que dois avaliadores, analisando a mesma ligação, cheguem à mesma nota.
É um bom conselho. E, sozinho, resolve o problema errado.
O que a calibração realmente resolve
A calibração fecha uma lacuna real: sem ela, o 4 de um avaliador é o 2 de outro, o coaching vira algo arbitrário e os agentes concluem, com razão, que o sistema todo é injusto. É ela que faz uma nota significar a mesma coisa, não importa quem esteja avaliando.
Mas repare no que a calibração nunca pergunta. Ela nunca pergunta se vale a pena avaliar aquele critério. Dois avaliadores podem passar uma hora em total acordo de que um agente tirou 2 em "empatia no tom de voz", e nenhum dos dois faz ideia se esse 2 já teve alguma correlação com um cliente que ficou, saiu, reclamou ou voltou mais satisfeito.
A maioria dos programas de QA investe um esforço enorme para garantir que o scorecard seja aplicado de forma consistente, e quase nenhum para garantir que ele seja aplicado de forma correta. Consistência responde: "todo mundo avaliou do mesmo jeito?". Correção responde outra pergunta: esse critério, avaliado com perfeição, prevê algo real sobre o relacionamento com o cliente?
As duas perguntas acabam se confundindo, porque um scorecard bem calibrado passa a sensação de rigor. Ele tem seções com pesos, confiabilidade entre avaliadores e sessões mensais para resolver divergências. Tudo isso gera confiança real: confiança de que a nota é justa, não de que a nota importa.
Por que ninguém criou um teste para isso
Existem três motivos principais, e nenhum deles tem a ver com alguém fazendo mal o próprio trabalho.
O primeiro é técnico. Testar se um critério tem correlação com um resultado lá na frente (churn, retenção, recontato, receita) exige conectar dados que normalmente ficam em sistemas diferentes, de times diferentes: o scorecard em operações ou qualidade, os dados de resultado em produto, dados ou finanças, às vezes nos três. Fazer isso manualmente, para cada critério, de forma contínua, é tão difícil que a maioria das empresas nem tenta. Elas ficam com o que conseguem medir bem: se a avaliação é consistente.
O segundo é histórico. Muitos dos critérios atuais foram escritos quando o QA era, antes de tudo, um exercício de compliance e aderência ao script. O agente leu o aviso obrigatório? Seguiu as etapas exigidas? Essa é uma função legítima e ainda essencial. Mas, conforme as exigências sobre a experiência do cliente foram muito além do compliance, a maioria dos scorecards não foi redesenhada para acompanhar. Eles ainda medem o que foram feitos para medir anos atrás, não o que importa hoje.
O terceiro agrava os outros dois. Os líderes costumam ser avaliados pelas mesmas notas e SLAs que o próprio scorecard gera. Bater essas metas aparece na avaliação de desempenho deles e, às vezes, na remuneração variável. Isso cria um desincentivo para ir mais fundo: um dashboard no verde é bom para todo mundo que é medido por ele, e descobrir que os critérios por trás não preveem nada real não é uma notícia confortável para levar à própria liderança.
Um incentivo parecido vale para os agentes de IA. Um fornecedor que define, reporta e às vezes cobra com base na taxa de resolução do próprio bot tem pouco motivo para testar se esse número bate com o que os clientes viveram.
Ninguém precisa agir de má-fé para isso acontecer. Os incentivos só nunca apontaram para a descoberta.
Uma lacuna que começa a se fechar
O pensamento do setor está começando a mudar, e o motivo é tecnologia, não só conscientização. Testar cada critério contra resultados reais exigia justamente aquele trabalho manual de correlação entre sistemas, tão difícil que quase ninguém tentava em escala. A IA começou a mudar isso, e a conversa está mudando junto. Algumas plataformas mais novas já alertam contra montar um scorecard em torno do que é fácil de medir, em vez do que realmente gera resultado. Outras apontam que métricas como CSAT e recontato muitas vezes entram no scorecard sem que ninguém estabeleça como elas se conectam aos comportamentos por trás delas.
O que ainda falta na maioria é um método completo: uma forma repetível de pegar um scorecard existente, testar cada critério contra dados reais de resultado, em escala, e saber o que manter e o que aposentar. Grande parte das orientações básicas do setor foi escrita para um mundo em que esse tipo de teste não era viável, por isso a calibração ainda costuma ser tratada como a última etapa. A tecnologia andou mais rápido que o playbook.
Outra pergunta a fazer
Nada disso significa que scorecards são uma má ideia ou que a calibração deve parar. A calibração nunca foi o objetivo final. Ela deveria ser o primeiro passo, seguido de um segundo, mais difícil: esse critério, depois que todo mundo concorda em como avaliá-lo, prevê de fato o resultado que importa para o negócio?
É uma disciplina diferente da que o QA pratica tradicionalmente, mais próxima de como um time de produto faz um teste A/B antes de lançar uma mudança do que de como um call center monta uma rubrica: teste o critério contra a realidade, mantenha o que se sustenta, aposente o que não se sustenta e trate o scorecard como algo a ser testado de novo, não definido uma vez e confiado para sempre.
O padrão aparece com frequência quando alguém de fato olha: um critério que todo mundo considera importante (tom, fraseado, uma frase específica do script) não move nada mensurável. Enquanto isso, comportamentos que ninguém pensou em avaliar, como a forma de conduzir uma escalação ou o que acontece nos 60 segundos depois que o cliente diz que está frustrado, podem importar mais do que qualquer coisa que o scorecard mede.
Os agentes de IA aumentam ainda mais o risco. Um chatbot pode ser ajustado para cumprir cada linha do script, cada aviso obrigatório e cada frase educada, então num scorecard típico ele pode ficar perto do topo. Um dashboard no verde diz pouco sobre se o bot entendeu a pergunta, deu a resposta certa ou soube a hora de passar o atendimento para uma pessoa.
Uma distinção pesa especialmente em serviços financeiros: nem todo critério existe para prever resultados. Avisos obrigatórios, verificação de identidade e outras exigências regulatórias continuam no scorecard. Os critérios que vale testar são todos os outros: as medidas de comportamento e de qualidade que deveriam moldar a experiência do cliente.
E errar aqui custa caro. As empresas de serviços financeiros superestimam o quanto lidam bem com reclamações de clientes: 60% acreditam que seus clientes estão satisfeitos, enquanto só 22% dos clientes dizem que estão, segundo pesquisas do setor. Um scorecard que nunca foi testado contra resultados é exatamente o tipo de sistema que produz uma lacuna assim e nunca a detecta.
O problema não é o scorecard. É nunca verificar se ele está certo.
A maioria dos programas de QA investe um esforço enorme para garantir que o scorecard seja aplicado de forma consistente, e quase nenhum para garantir que ele seja aplicado de forma correta.
O custo do QA manual
É difícil colocar preço no scorecard não testado. Já o custo de rodar o QA manualmente, não.
Para um contact center típico de médio porte, com cerca de 250 agentes, o QA manual e de baixa cobertura custa entre US$ 1 milhão e US$ 1,5 milhão por ano, segundo a estimativa, em capacidade perdida e oportunidades de melhoria desperdiçadas. Para uma operação enterprise, com cerca de 2.500 agentes, o valor sobe para US$ 10 milhões a US$ 15 milhões por ano, sem contar grandes falhas de compliance, vendas perdidas ou churn.
A estimativa se baseia em benchmarks publicados de dimensionamento de equipe, dados de remuneração e um conjunto transparente de premissas.
por ano
Operação com 250 agentes
por ano
Operação com 2.500 agentes
Custo anual estimado de capacidade perdida e oportunidades de melhoria desperdiçadas.
Como o número é calculado
A estimativa parte de um valor por agente: perda de produtividade de aproximadamente US$ 5.000 por agente de contact center por ano, dentro de uma faixa razoável de US$ 2.000 a US$ 11.000, conforme a complexidade das interações, a exposição a vendas, a regulação e a maturidade do programa de QA atual. Com US$ 5.000, uma operação de 250 agentes perde cerca de US$ 1,25 milhão por ano, e uma de 2.500 agentes, cerca de US$ 12,5 milhões: os pontos médios das faixas.
Essa estimativa usa um conjunto específico de premissas:
- Um analista de QA para cada 30 agentes, em linha com as proporções de equipe publicadas pelo setor, de aproximadamente 1:20 a 1:30
- Custo total médio de um analista de QA de aproximadamente US$ 79.000: salário-base perto de US$ 59.000 (segundo o salary.com), mais benefícios e encargos do empregador
- Automação de QA capaz de eliminar ou redirecionar cerca de 60% do trabalho de avaliação manual, número que os fornecedores reportam de forma consistente, mas que vale tratar como direcional, não como retorno garantido
- Um supervisor para cada 15 agentes, em linha com os benchmarks típicos de dimensionamento, com a administração do QA manual consumindo cerca de 12% da capacidade do supervisor, metade dela recuperável
- Maior cobertura de interações, coaching mais rápido e detecção mais cedo de problemas elevando a produtividade geral dos agentes em aproximadamente 3%
- Custo anual total por agente de US$ 60.000
Esses números cobrem o custo de rodar o QA manualmente, mas não consideram se os critérios avaliados são os certos. Automação, sozinha, não resolve isso.
O que o teste revela de verdade
O Nubank, banco digital em rápido crescimento com mais de 100 milhões de clientes, tinha montado seu scorecard de QA do jeito que a maioria das empresas faz: 16 critérios, com pesos, calibrados até que os avaliadores concordassem de forma consistente sobre o que cada nota significava. Por qualquer critério convencional, era um programa maduro.
Até o Nubank testar se algum dos 16 critérios previa de fato algo real sobre o relacionamento com o cliente.
O banco cruzou cada critério com resultados reais de clientes, em vez de só confiar que uma avaliação consistente significava um scorecard correto. Oito dos 16 se sustentaram. Os outros oito tinham sido avaliados, usados em coaching e calibrados por anos sem nunca provar nada mensurável.
A KOHO, fintech e app de banco digital canadense, chegou a uma conclusão parecida, por outro caminho. Em vez de testar um critério por vez, a KOHO passou a avaliar cada interação com clientes e deixou o padrão aparecer. Descobriu que erros de gramática, considerados por muito tempo um problema sério, quase não faziam diferença. O que importava de verdade era empatia. O coaching mudou de acordo: saiu da perfeição no script e foi para a conexão humana que de fato gerava resultado.
O resultado não foi só um scorecard melhor. Foi uma função de QA totalmente diferente. Analistas que antes passavam o tempo revisando manualmente uma pequena amostra agora dedicam esse tempo a coaching e treinamento, a partir do que a cobertura total automatizada revela. O time de suporte da KOHO continua praticamente do mesmo tamanho, mesmo com a base de usuários dobrando: escala com tecnologia, não com headcount.
Juntos, os dois casos apontam na mesma direção. Testar o próprio teste não só valida scorecards, como muda o rumo deles. Revela o que realmente move o relacionamento com o cliente e descarta o que nunca fez diferença. Aí o coaching pode ir atrás.
Não foi preciso mais gente no QA nem um scorecard mais longo. Foram precisas duas coisas que a maioria dos programas manuais nunca tem ao mesmo tempo: cobertura ampla o suficiente para enxergar o padrão completo e a capacidade de testar o que essa cobertura de fato prevê.
Testar o próprio teste não só valida scorecards, como muda o rumo deles. Revela o que realmente move o relacionamento com o cliente e descarta o que nunca fez diferença.
Como fechar essa lacuna
Nada disso é falta de esforço. A maioria dos times de QA trabalha duro dentro de sistemas que nunca foram feitos para conectar scorecards a resultados, sob incentivos que premiam um dashboard no verde em vez de uma descoberta incômoda. Nubank e KOHO mostram que isso está começando a mudar.
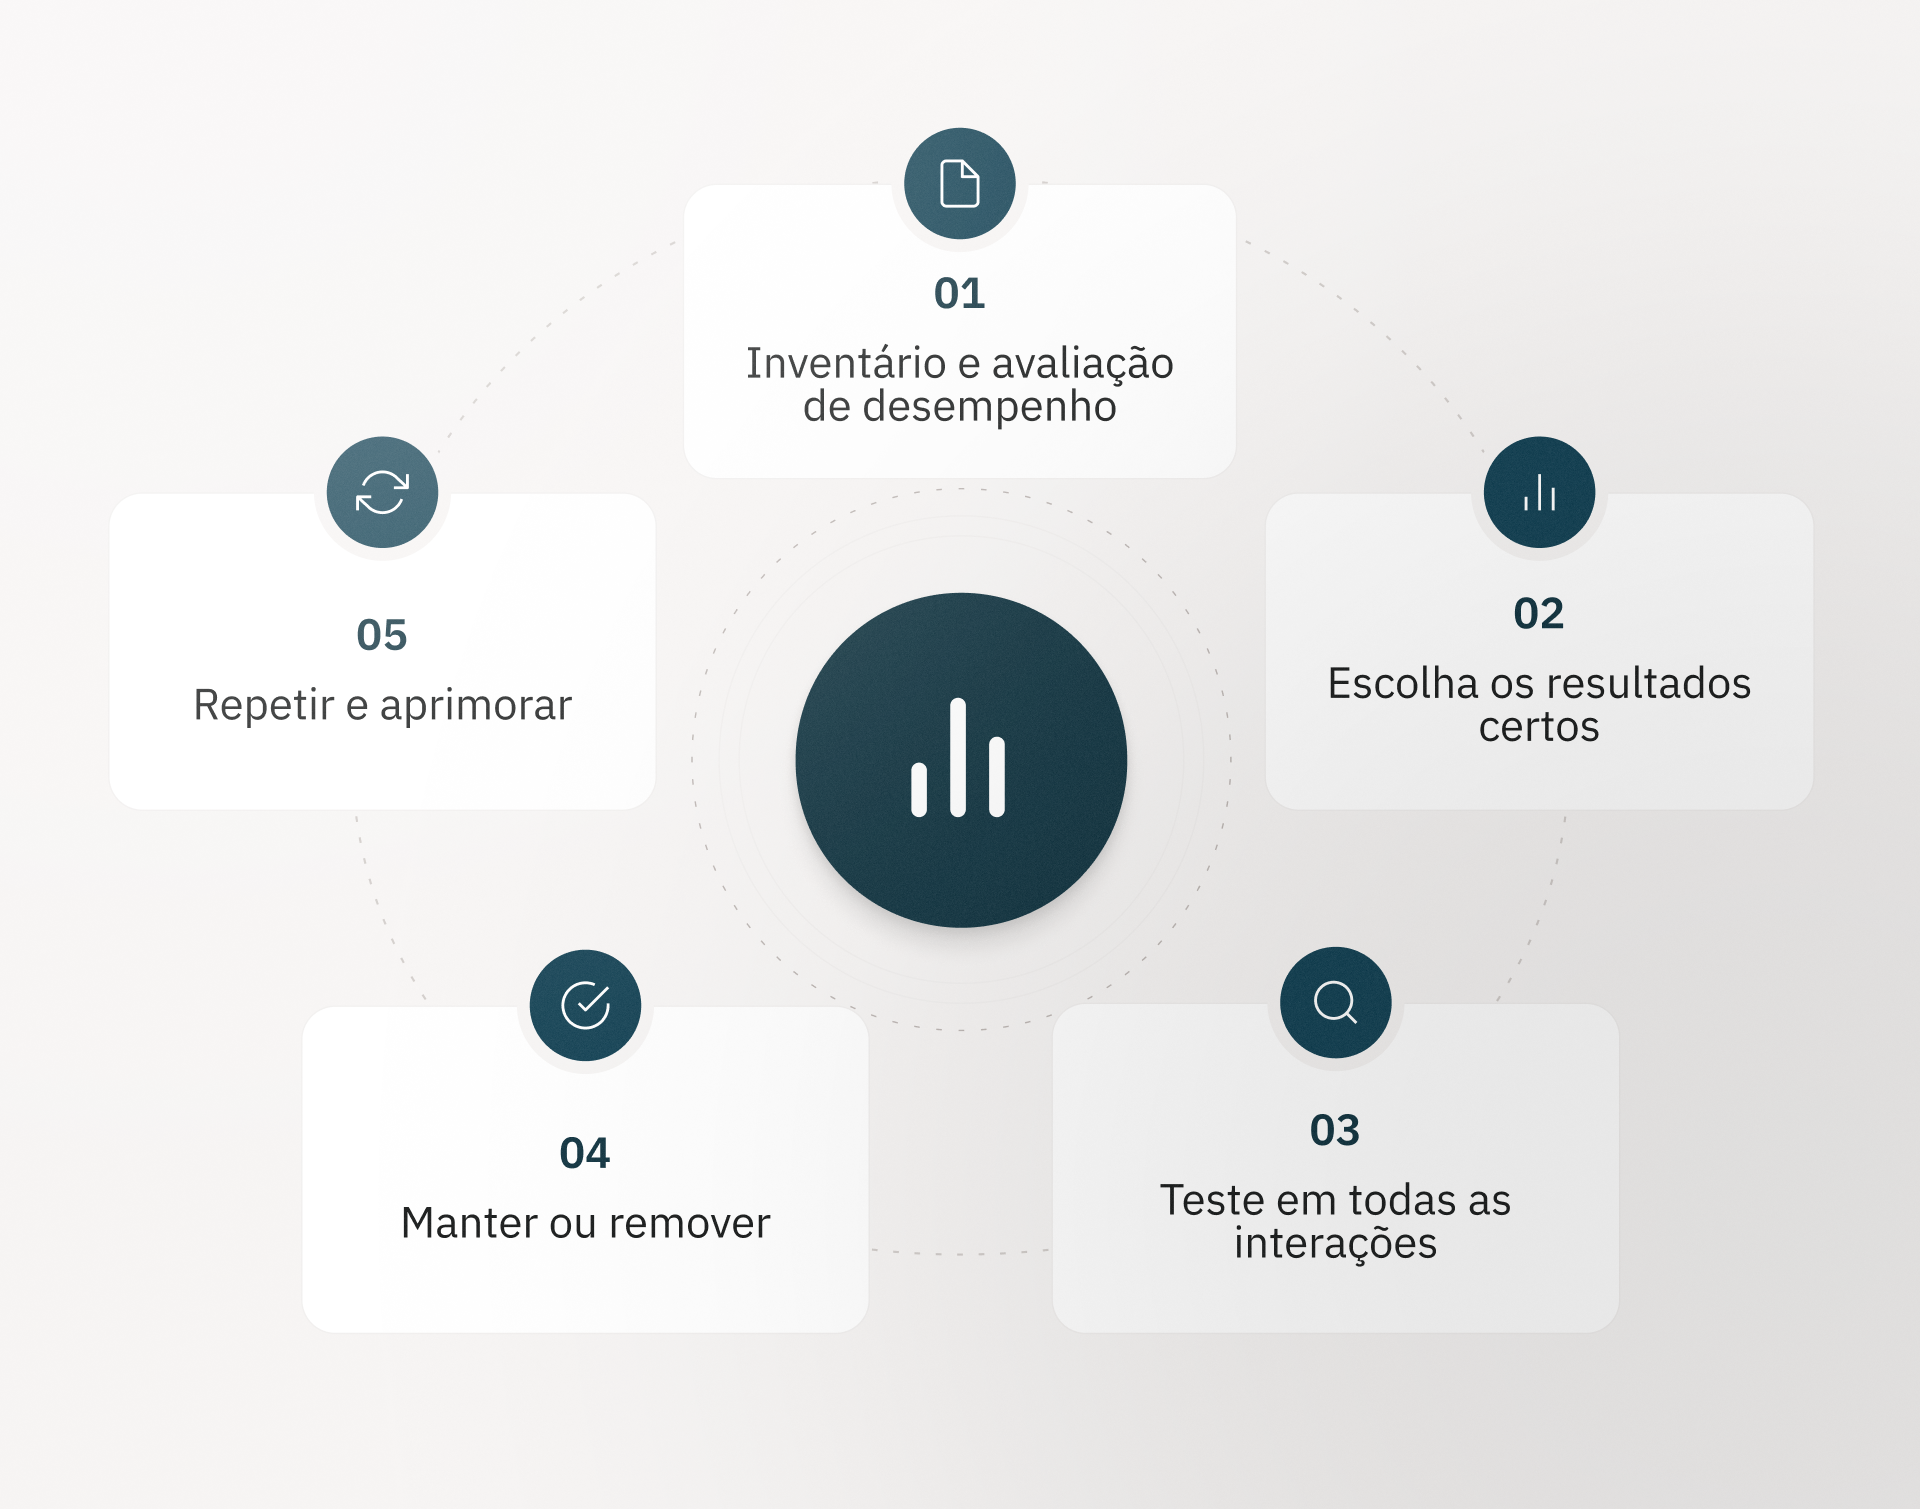
O playbook que essas empresas seguiram é repetível. Faça o inventário do scorecard e separe as exigências regulatórias. Escolha os resultados que realmente importam para o negócio, como recontato, reclamações, churn e retenção. Teste cada critério restante contra eles, com cobertura total das interações, incluindo times terceirizados e agentes de IA. Mantenha o que prevê resultado, aposente o que não prevê e procure comportamentos que importam mas nunca foram avaliados. Depois repita isso periodicamente, porque um scorecard que se sustentou no ano passado pode não se sustentar este ano.
Em serviços financeiros, um scorecard testado contra resultados reais é uma evidência mais forte para os times de compliance e risco. Ele mostra que as medidas de qualidade se conectam ao que de fato acontece com os clientes, não só que os avaliadores concordaram entre si. E também cobra das pessoas, dos times terceirizados e dos agentes de IA o mesmo padrão de resultado, com avaliação independente de quem os opera.
Isso pesa mais a cada novo deploy de IA. Conforme os agentes de IA assumem mais trabalho na linha de frente, o scorecard não avalia mais só pessoas. Ele avalia sistemas que são ajustados para entregar o que o scorecard premia, e um scorecard não testado pode ensinar a lição errada a um agente de IA mil vezes antes que alguém perceba. O CFPB, órgão de proteção ao consumidor financeiro dos EUA, apontou esse risco anos atrás. Alertou que chatbots no setor financeiro podem não reconhecer contestações e passar informações incorretas, e que as instituições que os adotam ficam expostas a risco de compliance.
O custo de não fazer nada não é abstrato. Só o QA manual pode custar, segundo a estimativa, de US$ 1 milhão a US$ 1,5 milhão por ano para um contact center de médio porte e de US$ 10 milhões a US$ 15 milhões para uma grande instituição financeira, antes de considerar um scorecard que ninguém testou contra resultados reais.
As instituições financeiras têm em mãos milhões de ligações por ano, todas com sinais reais sobre risco, retenção e o próximo passo do cliente. A maioria desses sinais é arquivada como registro de compliance em vez de virar ação. Quando isso muda, o QA deixa de ser uma nota que um time defende numa reunião de resultados. Vira algo estratégico, sobre o qual um COO pode basear decisões de alocação de recursos.
Veja a Birdie em ação.
Veja como a Birdie transforma sinais dos clientes em decisões de retenção, expansão e adoção. 30 minutos. Demo ao vivo, com resultados.